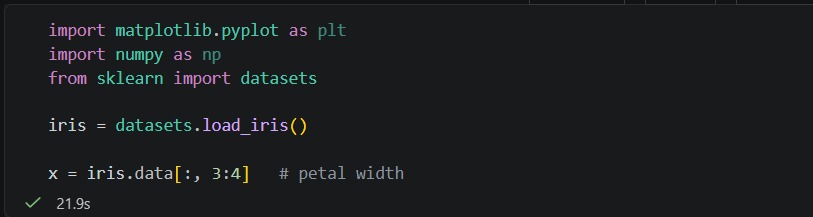
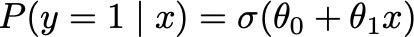Lo primero es importar los datos de nuestro dataset, en este caso se encuentran en la librería scikit-learn. Con la librería instalada, extraemos los datos:
import matplotlib.pyplot as plt
import numpy as np
from sklearn import datasets

iris = datasets.load_iris()

x = iris.data[:, 3:4]   # petal width
y = iris.target
print(y)
Los valores de "y" son 0, 1 o 2 según el tipo de flor, esto se muestra en la siguiente imagen:
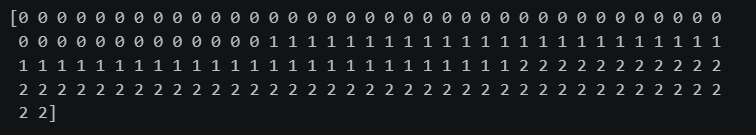
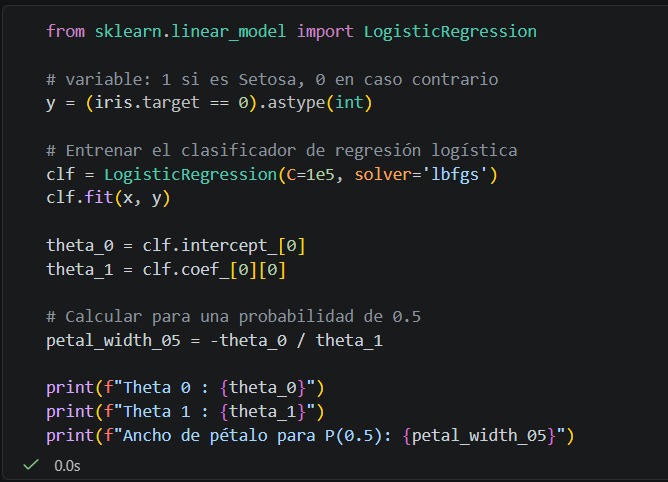
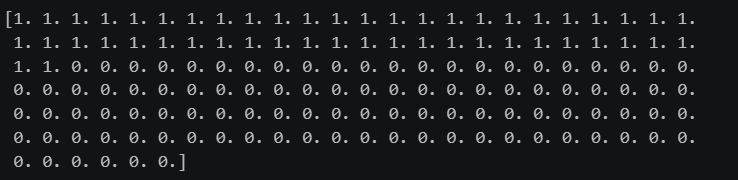
Al revisar nuestros datos se puede ver que el tipo setosa corresponde al número 0, entonces para nuestro clasificador hacemos que solo sean 1 o 0 los valores de “y”, donde 1 corresponde a setosa y 0 a uno de los otros dos tipos. Esto se hace con la siguiente instrucción y se visualiza el cambio de datos en la imagen:
y = (y==0).astype(float)
print(y)
Se importa la clase del modelo de regresión, creamos un modelo con una variable que será de esa clase. Después, se entrena el modelo, para esto se utiliza la función fit() y se le mandan las entradas (x) y los datos de target “y”. Ahora no se necesitó crear una matriz con la primera columna de 1’s, la función ya lo hace, solo hay que mandar los valores de x1.
from sklearn.linear_model import LogisticRegression
modelo = LogisticRegression()
modelo.fit(X=x,y=y)
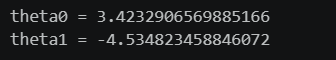
Con lo anterior ya está el modelo listo, ahora solo se extraen los valores de θ y se imprimen para conocer su valor. Se utiliza la función item() para los valores debido a que estos se encuentran en un arreglo aunque solo son un dato, θ_0 esta en un [] y θ_1 en [[]]. Se puede ver que los nombres donde se encuentran los valores de theta hacen referencia a la ecuación de la recta, donde θ_0 corresponde al cruve con el eje vertical (intercepción) y θ_1 a la pendiente o coeficiente de la entrada.
theta0 = modelo.intercept_.item()
theta1 = modelo.coef_.item()
print(f"theta0 = {theta0}")
print(f"theta1 = {theta1}")
Al imprimirlos tenemos que:
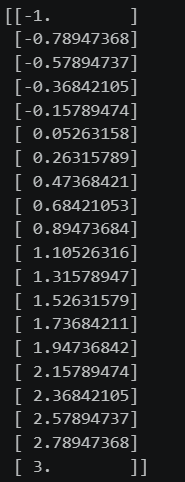
Ahora que ya conocemos nuestro modelo podemos observar que es lo que nos entrega si lo evaluamos en un rango de x (en este caso de -1 a 3), es necesario utilizar .reshape(-1,1) para que tengamos un vector de n filas y 1 columna. Al evaluar con predict_proba() e imprimir podremos visualizar los datos obtenidos.
x_prueba = np.linspace(-1,3,20).reshape(-1,1)
print(x_prueba)
ymodelo=modelo.predict_proba(x_prueba)
print(ymodelo)
En la siguiente figura observamos nuestro vector de x que se meterá al modelo, el rango de -1 a 3 se elegió para que se alcance a visualizar la forma de sigmoide:
En la siguiente figura tenemos los valores obtenidos del modelo, donde la primera columna es la probabilidad de que sea 0 y la segunda columna la probabilidad de obtener un 1.
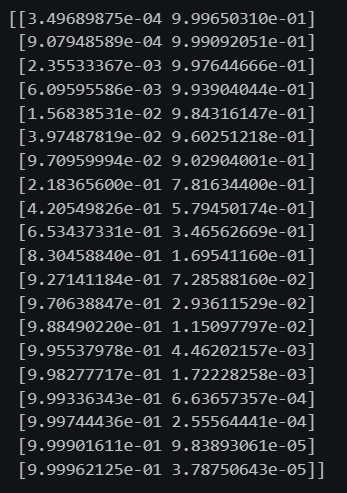
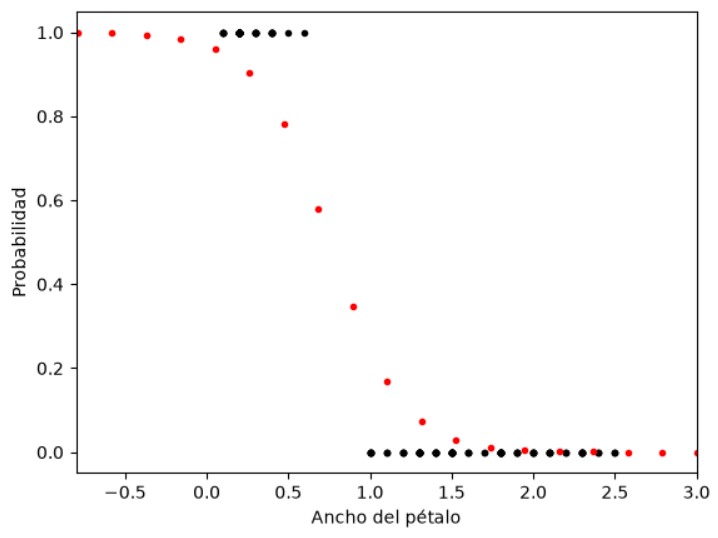
Con estos datos se puede graficar el modelo y ver que tiene un comportamiento como la función sigmoide. Para esto se grafican los datos de “x” y “y” del modelo original (los “y” ya convertidos en 0 y 1), también se grafica nuestro modelo evaluado, pero únicamente se toma la segunda columna que indica la probabilidad de que sea 1.
plt.plot(x,y, '.k')
plt.plot(x_prueba, ymodelo[:, 1], '.r')
plt.xlabel("Ancho del pétalo")
plt.ylabel("Probabilidad")
plt.xlim(-0.8,3)
plt.show()
Finalmente, para conocer qué valor corresponde a la probabilidad de 0.5 hay que recordar nuestro modelo:
y^ = θ_0 + θ_1 x1
También si recordamos la función sigmoide = 1/(1+e^-modelo)
Entonces tendremos 0.5 cuando nuestro modelo será igual a cero. Simplemente igualamos a cero y despejamos x1:
x1=-θ_0/θ_1
x1=-theta0/theta1
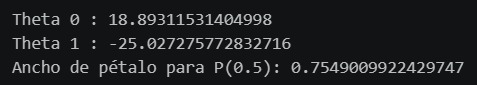
print(f"El valor de ancho para 0.5 es: {x1}")
Esto nos da el siguiente resultado: